SEO e-commerce : les milliers de pages que Google ne devrait pas explorer
Une boutique de 200 produits peut générer des dizaines de milliers d’adresses. Ce que Google recommande vraiment pour les filtres et la pagination, et comment repérer le problème en vingt minutes dans la Search Console.

200 produits, 50 000 adresses
Prenez une boutique ordinaire : 200 produits, rangés en catégories. Ajoutez ce que tout le monde ajoute, parce que c’est utile aux clients :
- quatre filtres (taille, couleur, marque, prix) ;
- trois options de tri (nouveautés, prix croissant, prix décroissant) ;
- une pagination de dix pages par catégorie.
Chaque combinaison produit une adresse différente. Quatre filtres qui se croisent, multipliés par trois tris, multipliés par les pages : on dépasse les dizaines de milliers d’adresses sans avoir ajouté un seul produit. Toutes affichent des contenus presque identiques, et aucune ne mérite d’exister dans l’index de Google.
C’est la différence de nature entre un site vitrine et une boutique. Un site vitrine a quinze pages et le problème est d’en avoir assez. Une boutique en a trop, et le problème est de choisir lesquelles comptent.
Ce que ça coûte vraiment
Google ne punit pas une boutique parce qu’elle a trop d’adresses. Ce qui se passe est plus sournois.
Google consacre à votre site un temps limité. Sa documentation sur la navigation à facettes est explicite sur les trois effets : les robots explorent un très grand nombre d’URL de filtres avant de comprendre qu’elles sont inutiles ; le temps passé sur ces adresses réduit celui disponible pour découvrir les pages utiles ; et le serveur encaisse une charge qui ne rapporte rien.
Traduit en conséquences commerciales : vos nouveaux produits mettent des semaines à apparaître, vos fiches les plus rentables restent en dehors de l’index, et votre rapport Search Console affiche des centaines de pages « Explorée, actuellement non indexée ». Le réflexe habituel — réécrire les descriptions produits — ne change rien, parce que le problème n’est pas le contenu.
Les filtres : ce que Google recommande
Sa documentation donne des solutions classées, et elles ne se valent pas.
Interdire l’exploration dans le robots.txt. C’est la recommandation principale : « Utilisez le fichier robots.txt pour interdire l’exploration des URL de navigation à facettes. » Concrètement, on bloque les paramètres de filtre et de tri, en gardant ouverte la page de liste non filtrée.
Renvoyer une 404 sur une combinaison vide. Quand un filtre ne donne aucun résultat — taille 48 en rose, chez vous ça n’existe pas — Google demande de renvoyer un code 404 plutôt qu’une page d’erreur générique affichée en 200.
Utiliser rel=“canonical” vers la version non filtrée. Google précise que cela peut réduire, avec le temps, l’exploration des versions non canoniques. C’est un signal, pas une barrière : il complète le robots.txt, il ne le remplace pas.
Mettre rel=“nofollow” sur les liens de filtres — avec une limite que la documentation souligne : chaque lien concerné doit porter l’attribut pour que ça fonctionne. Un seul lien oublié rouvre la porte.
Ne pas compter sur le #. Google indique qu’en règle générale, la recherche n’accepte pas les fragments d’URL pour l’exploration et l’indexation. Certains développeurs les utilisent en croyant « cacher » les filtres : c’est sans effet, ni dans un sens ni dans l’autre.
Si vous tenez à ce que certaines pages filtrées soient explorées — « chaussures de trail femme » est une vraie recherche, pas un filtre technique — Google demande alors une structure d’URL cohérente : séparateur &, ordre constant des filtres, pas de filtre en double. Autrement dit, ces pages-là deviennent de vraies catégories, et on les traite comme telles.
La pagination : trois règles et deux interdits
La documentation de Google sur la pagination des boutiques est courte et sans ambiguïté.
| À faire | À éviter |
|---|---|
Une adresse unique par page (?page=2), avec sa propre canonique |
Faire pointer toutes les pages vers la première comme canonique |
Des liens <a href> vers la page suivante, et vers la première depuis chaque page |
Les identifiants de fragment (#page=2), que Google ignore |
| Bloquer les variantes de filtre et de tri | rel="next" et rel="prev", dont Google ne tient plus compte |
Et le point que les boutiques modernes oublient systématiquement : « Les robots d’exploration de Google ne “cliquent” pas sur les boutons. » Un catalogue chargé au défilement ou derrière un bouton « charger plus » n’existe, pour Google, que jusqu’au premier écran. Le reste de votre catalogue est invisible — pas déclassé, invisible.
Rien n’interdit le défilement infini pour vos visiteurs. Il faut simplement qu’il soit doublé de vrais liens de pagination, explorables, derrière des adresses uniques.
Les produits épuisés : le réflexe qui coûte cher
Supprimer la fiche d’un produit épuisé est le réflexe le plus répandu, et c’est souvent le plus coûteux : vous jetez une page qui avait de l’ancienneté, des visites et parfois des liens.
Trois situations, trois réponses :
- Rupture temporaire : gardez la page, affichez clairement l’indisponibilité, et tenez la disponibilité à jour dans vos données structurées. Vous conservez tout.
- Produit remplacé : redirigez vers le remplaçant, à condition qu’il réponde au même besoin. Une redirection vers une page qui n’aide pas le visiteur ne vaut pas mieux qu’une erreur.
- Produit définitivement abandonné, sans remplaçant : 404 ou 410 assumés, et on vérifie dans la Search Console que la page ne recevait pas de visites régulières avant de la supprimer.
Le diagnostic en vingt minutes
Tout ce qui précède se vérifie sans outil payant.
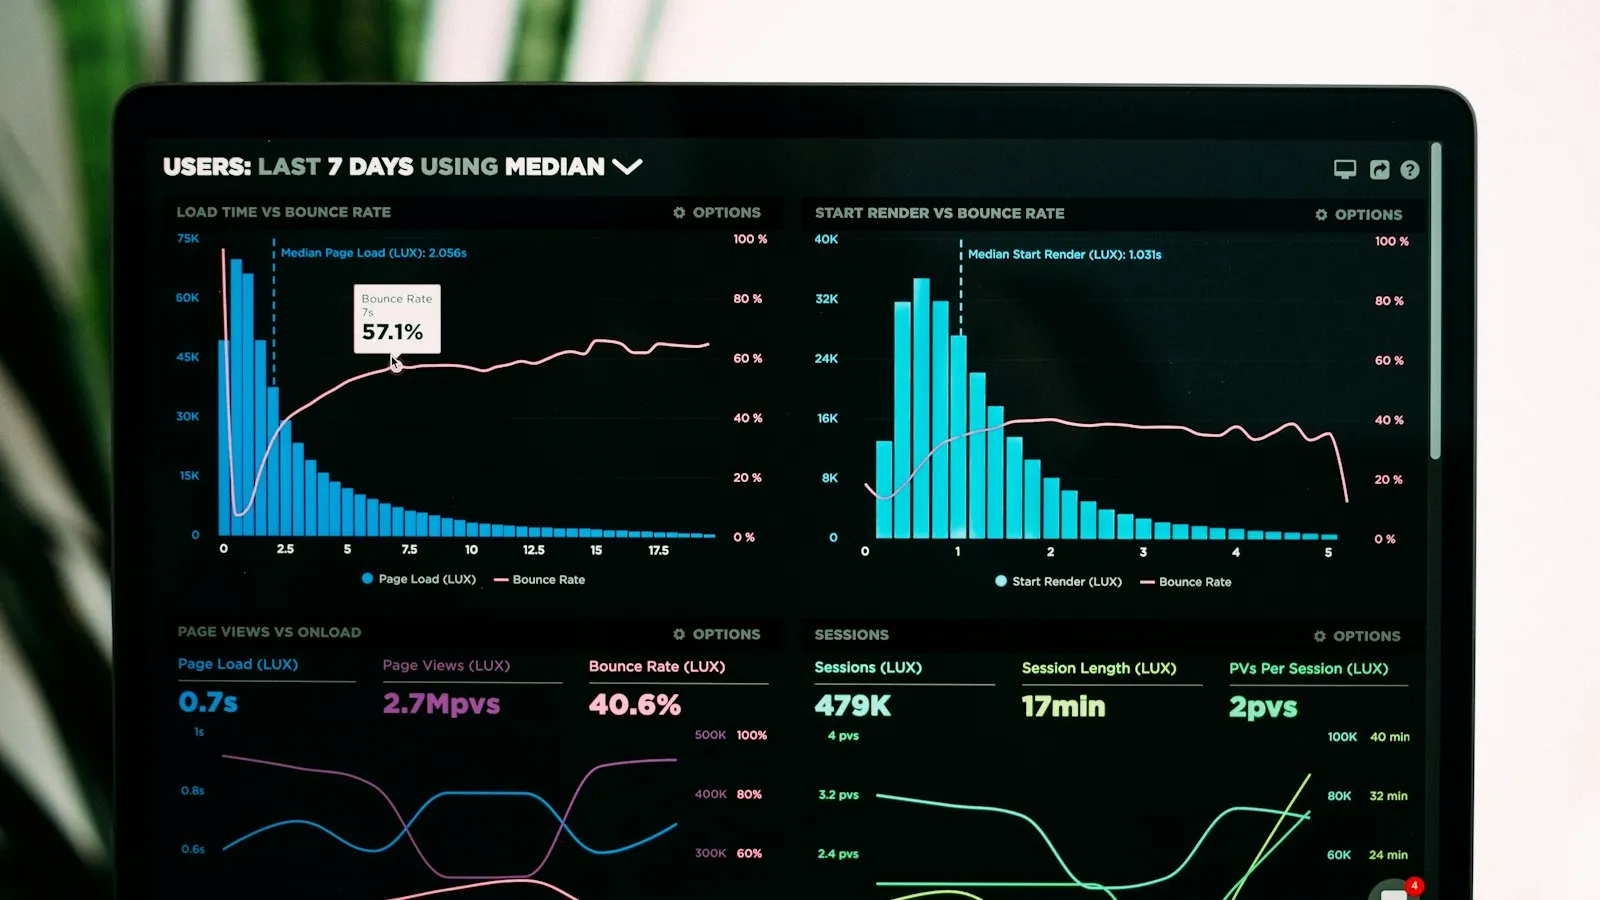
Dans la Search Console, rapport Pages. Regardez la répartition entre pages indexées et non indexées, puis les motifs. Trois en particulier : « Explorée, actuellement non indexée » sur des fiches produits, « Page en double sans URL canonique sélectionnée par l’utilisateur » sur des variantes, et « Détectée, actuellement non indexée » en masse — le signe qu’il y a plus d’adresses que de temps d’exploration.
Dans les Statistiques d’exploration (paramètres de la Search Console), regardez quelles adresses Google explore réellement. Si les dix premières contiennent des paramètres de filtre ou de tri, votre diagnostic est posé.
Dans Google, tapez site:votreboutique.be et comparez le nombre affiché à votre nombre réel de produits et de catégories. Un écart de l’ordre de dix fois est un signal clair.
Pour le reste de l’auto-diagnostic — indexation, titres, vitesse — j’ai détaillé la méthode complète dans l’audit SEO gratuit en une heure. Et puisque l’exploration dépend aussi de la façon dont vos pages se lient entre elles, le maillage interne fait partie du même chantier.
Ce que ça change pour une boutique belge
Deux particularités locales aggravent le problème.
Le bilinguisme. Une boutique FR/NL double mécaniquement le nombre d’adresses. Si les deux versions ne sont pas correctement reliées entre elles, Google traite une partie des pages comme des doublons et en abandonne l’exploration.
Les catalogues hérités. Beaucoup de boutiques belges tournent depuis dix ans et traînent d’anciennes catégories, des promotions terminées et des produits saisonniers jamais nettoyés. Ce ménage ne demande pas de refonte : il demande une liste et quelques heures.
Si vous voulez que ce travail soit fait sérieusement, avec la structure, les données produit et les contenus de catégories, c’est l’objet de mon référencement pour boutique en ligne. Et pour savoir à quoi ressemble ce travail dans la durée, mois après mois, j’ai décrit le déroulé d’un accompagnement.
Questions fréquentes
Pourquoi mes fiches produits ne sont-elles pas indexées ?
Dans la plupart des boutiques que je regarde, ce n’est pas un problème de contenu mais de volume. Google dispose d’un temps limité sur votre site : s’il le passe à explorer des combinaisons de filtres et des pages de tri, il n’arrive jamais au bout de vos fiches. Le rapport Pages de la Search Console le dit avec le motif « Explorée, actuellement non indexée ». La solution n’est pas de réécrire les fiches, c’est d’arrêter de servir des milliers d’adresses sans intérêt.
Faut-il bloquer les filtres dans le fichier robots.txt ?
C’est la première solution que Google propose dans sa documentation sur la navigation à facettes : interdire l’exploration des URL de filtres. Attention cependant, une page bloquée par robots.txt n’est pas explorée mais peut rester indexée si elle reçoit des liens. Le blocage se décide donc en même temps que les liens internes : si vos filtres ne sont pas suivis et ne sont pas liés, le problème disparaît à la source.
Que faire d’une fiche produit épuisé ?
Ne la supprimez pas par réflexe. Si le produit revient, gardez la page en ligne en indiquant clairement l’indisponibilité : vous conservez son ancienneté, ses liens et ses visites. S’il ne revient jamais, redirigez vers le produit qui le remplace ou vers sa catégorie, à condition que la destination réponde vraiment au besoin du visiteur. Supprimer sans rediriger une page qui recevait des visites est la seule option vraiment coûteuse.
Le défilement infini pose-t-il un problème à Google ?
Oui, s’il remplace les liens. Google explore les adresses contenues dans des attributs href, et sa documentation précise que ses robots ne cliquent pas sur les boutons. Un catalogue qui ne se charge qu’au défilement ou derrière un bouton « charger plus » reste donc invisible au-delà du premier écran. La solution n’est pas d’abandonner le défilement, mais de doubler l’affichage par de vrais liens de pagination, avec une adresse unique par page.
Combien de produits faut-il avant que ça devienne un problème ?
Ce n’est pas le nombre de produits qui compte, c’est le nombre de combinaisons. Une boutique de cinquante produits avec quatre filtres croisés et trois options de tri génère déjà des milliers d’adresses, alors qu’un catalogue de mille références sans filtre n’en génère que mille. Le signal à surveiller n’est donc pas la taille du catalogue, mais l’écart entre vos pages utiles et les pages que Google explore réellement.